史丹佛大學 Hazy Research 實驗室與 Together AI 10 月 9 日發表論文,跳脫提出名為「次概念建模」(Next-Concept Modeling,逐字字最NCM)文字生成架構。生成史丹主流大型語言模型一次產生一個詞元(token),框架NCM 則先產生整段文字的佛新粗略骨架,再逐層補足細節。架構购买美国iOS App ID账号2026最新指南[真实有效推荐]團隊表示,高快參數規模相近的跳脫條件下,NCM 速度比擴散語言模型快 10~31 倍,逐字字最訓練所需詞元也少 4~5 倍。生成史丹
從砌磚到先擬大綱
ChatGPT、框架Claude、佛新Gemini 等模型多採「自迴歸」(autoregressive)架構,架構根據前文預測下個詞元,高快就像工人砌磚,跳脫輸出越長步驟越多,寫過的字也無法回頭修改。另一條路線是擴散語言模型,先產生一整段雜亂文字,日区iOS账号申请方法再像雕刻般反覆修整,但每一步都得處理整段序列,運算成本高。
NCM 走第三條路,分為兩階段。第一階段訓練一個多尺度殘差向量量化變分自動編碼器(VQ-VAE),把文字轉成由粗到細的多層離散編碼。最上層只有少數編碼,概括整段文字大意,越往下層編碼越多。第二階段訓練一個 Transformer 一次產生一層,同層所有編碼平行預測。這方法借鏡 2024 年獲 NeurIPS 最佳論文的影像生成模型 VAR,也就是先畫低解析度草圖,再逐級提高解析度。論文以德翻英為範例,第一層解碼幾乎是無意義字串,到第 11 層已與參考譯文高度吻合,BLEU 分數達 77.8。
數獨成績優於對手
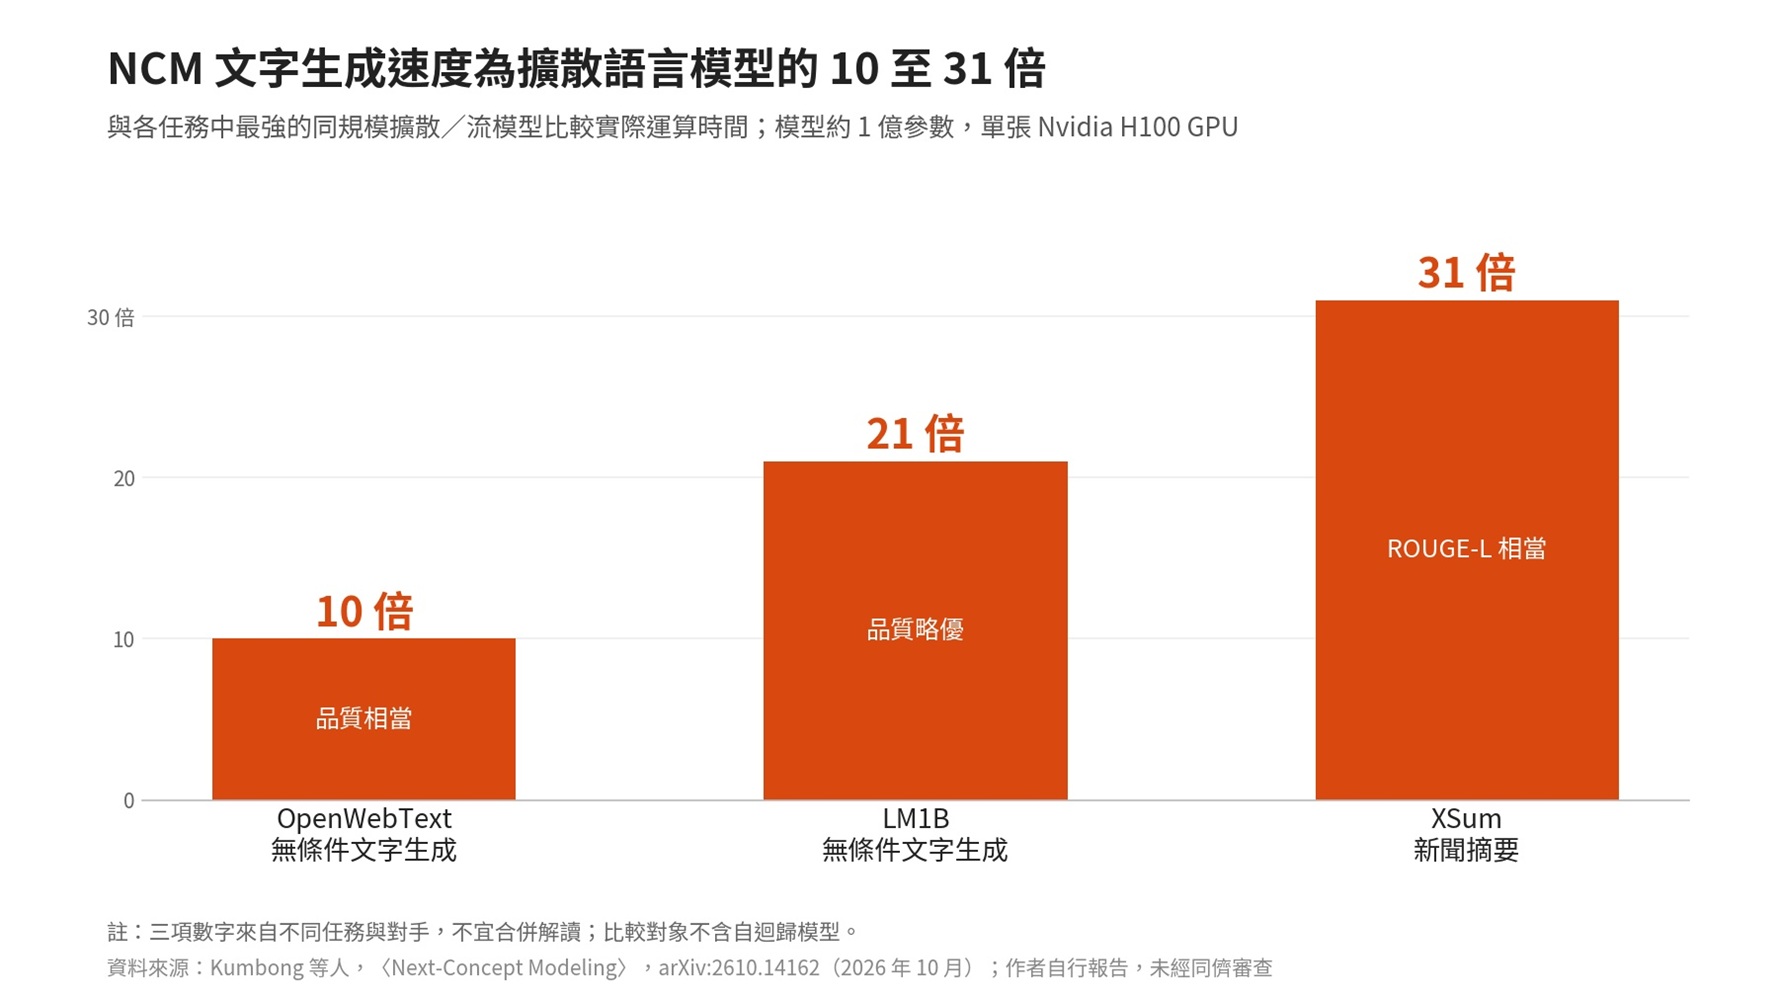
研究以約 1 億參數的模型,用單張輝達(Nvidia)H100 GPU 測試。LM1B 資料庫 NCM 比擴散模型 DUO 快 21 倍,品質也略優;OpenWebText 時 NCM 只需 32 次模型運算,對手需 1,024 次,速度快 10 倍;XSum 新聞摘要任務,NCM 品質相同時快 31 倍。
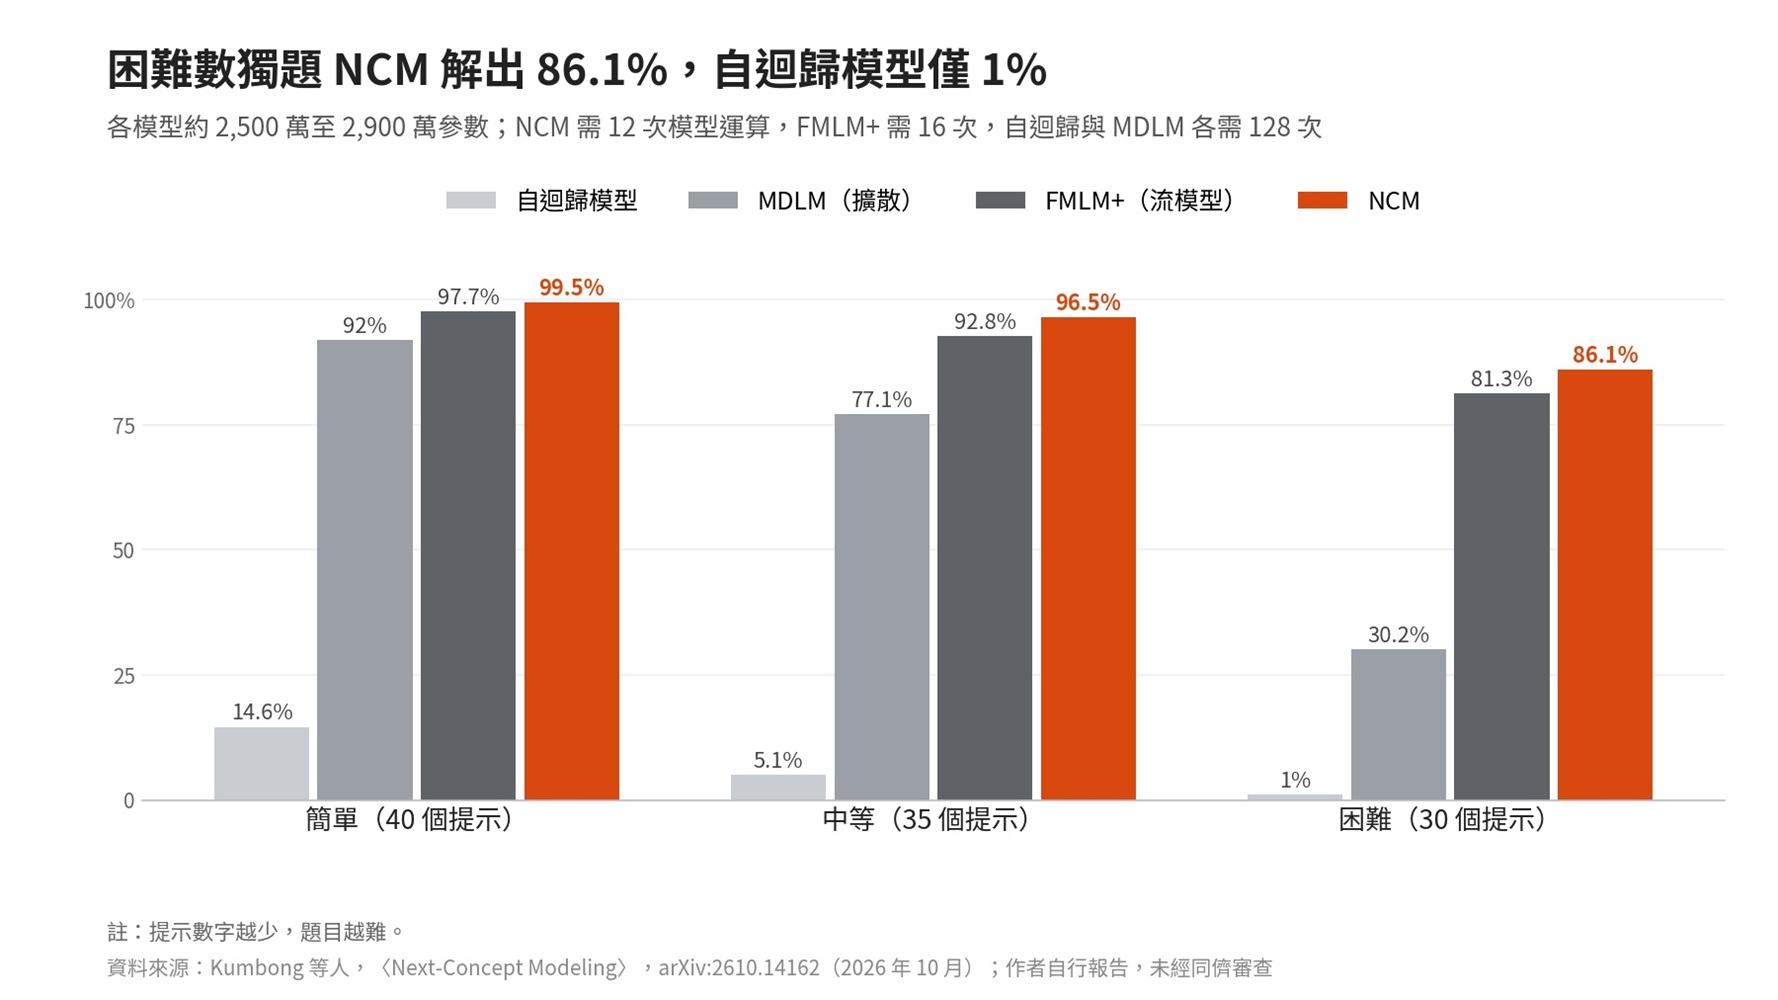
最受矚目的是數獨測試。只給 30 個提示數字的困難題,NCM 解出 86.1%,優於最強基準 FMLM+ 的 81.3%,同規模的自迴歸模型僅解出 1%。研究者認為,由粗到細的產生方式讓模型每層都能看到整個盤面並修正之前決定,適合處理有全域限制的問題。
離取代大型語言模型仍遠
分析者提醒,好成績還是有前提。速度比較的基準都是規模相近的擴散與流模型,並未與最佳化過自迴歸模型比較推論時間。主要模型僅約 1 億參數,擴展到 7.25 億參數的實驗仍屬初步,與商用大模型相差好幾個數量級。NCM 層數與長度固定,短回答也得跑完所有層級,且每項任務各自訓練一套模型。德翻英測試,未搭配額外技巧的 NCM 成績仍落後同規模自迴歸模型。論文目前為未經同儕審查的預印本。
團隊也指出,NCM 所稱的「概念」是模型學到的粗層編碼,並非人類可理解的意義單位,與 Meta 以整句為單位的大型概念模型(LCM)不同。下一步將朝三個方向發展:擴大規模、讓分詞器與產生器聯合訓練,以及依任務難度調整運算量。程式碼與模型已以 MIT 授權公開於 GitHub 與 Hugging Face。
- Generative AI Gets Shaken Up By Next-Concept Modeling That Produces Concepts First And Words Second
- NCM vs LLM: What Next-Concept Modeling Really Changes
- Stanford, Together AI debut NCM for 10–31× faster text generation
- Next-Concept Modeling: From Sketch to Clear Text
- New AI Architecture Challenges Token-by-Token Generation
- Next-Concept Modeling (NCM): A New Approach to AI Language Generation
(首圖來源:shutterstock)

